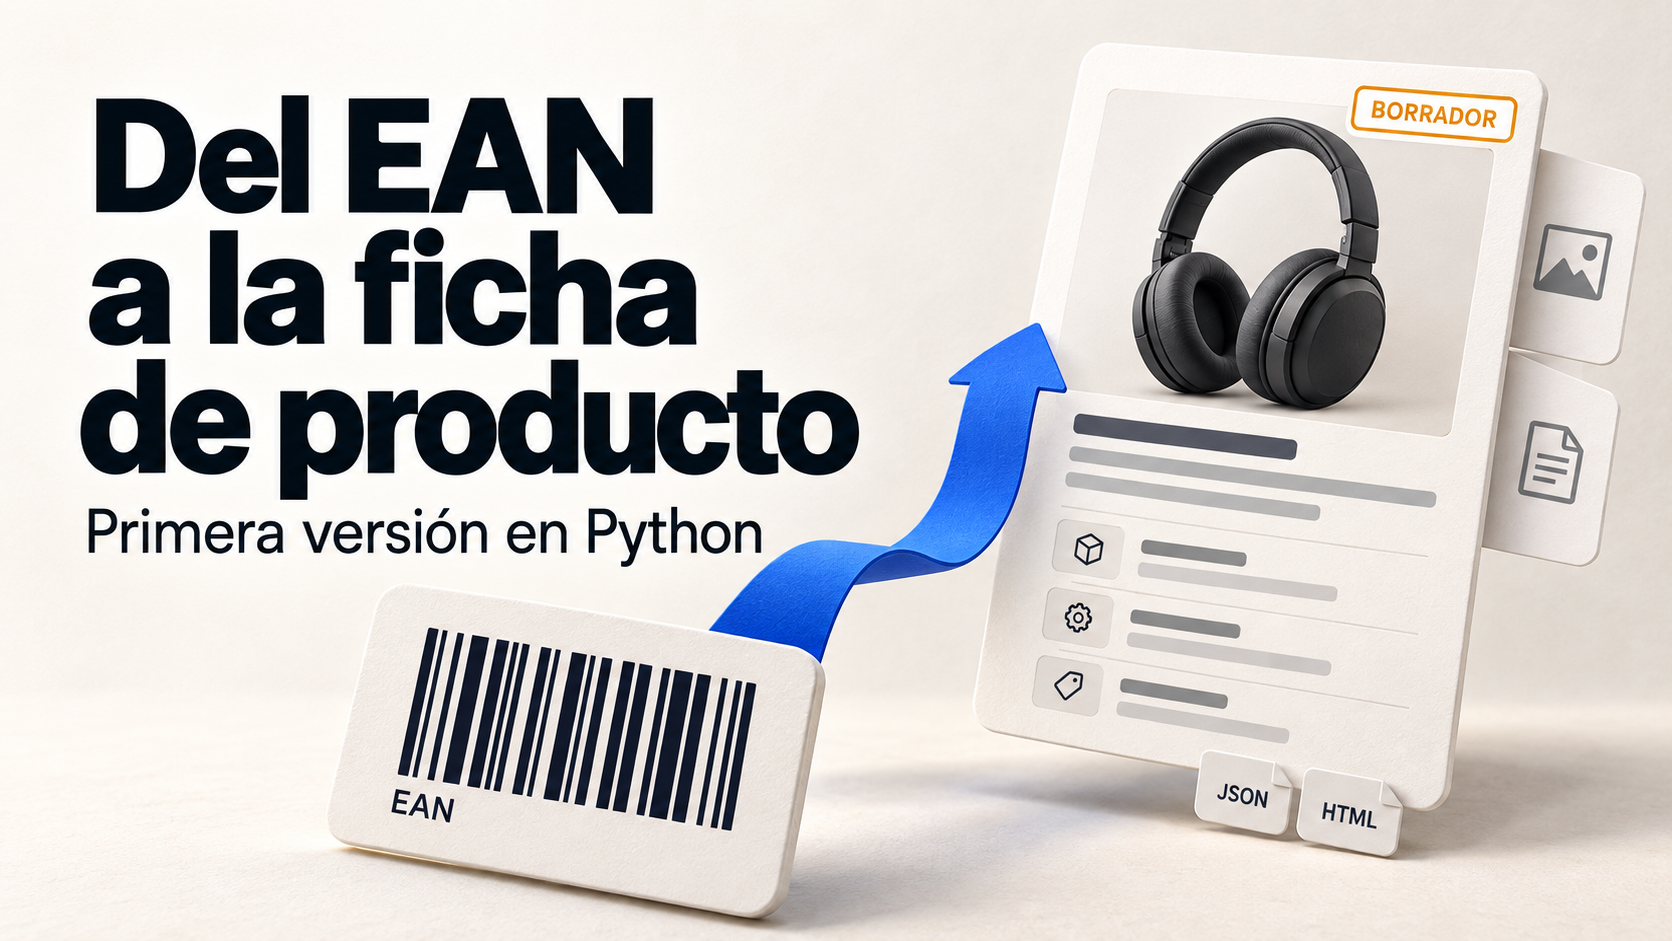
Hemos preparado una primera versión en Python de un generador de fichas de producto a partir de su código EAN. El desarrollo reúne investigación de fuentes, redacción, tratamiento de imágenes y comprobaciones de contenido. También hemos definido la arquitectura de una futura API para consultar las fichas guardadas y gestionar nuevas generaciones desde otras aplicaciones.
El punto de partida es una situación habitual al trabajar con catálogos: recibir un producto identificado por su código y necesitar información suficiente para describirlo. Resolverlo implica localizar la referencia exacta, comprobar sus características, encontrar imágenes adecuadas y organizar todo ese material en una ficha que pueda revisarse.
El programa está diseñado para recorrer ese proceso y conservar las evidencias utilizadas. La primera versión se ejecuta desde la consola y utiliza DeepSeek en las distintas etapas de investigación, redacción y revisión.
El recorrido comienza validando el código del producto. Después busca fuentes y extrae información para identificar marca, modelo y variante . Esa relación es especialmente importante cuando una misma familia incluye distintos colores, capacidades, tamaños o versiones regionales.
Los datos obtenidos se organizan como afirmaciones vinculadas a sus fuentes . A partir de ellas se construyen el título, las descripciones, los atributos técnicos, las preguntas frecuentes y los metadatos SEO. Los campos que necesitan información adicional quedan pendientes, y los datos comerciales, como precio o existencias, requieren una fuente propia del vendedor.
Las imágenes forman parte del mismo proceso. El código contempla la descarga y comprobación de los archivos candidatos, seguida de una inspección visual con el modelo para valorar su relación con el producto. La ficha conserva el texto alternativo, el pie y los avisos necesarios sobre variantes o accesorios. También registra los derechos pendientes de confirmar, porque encontrar una fotografía en una web pública no acredita su reutilización comercial.
Cada ejecución produce un archivo JSON con los datos estructurados y una previsualización HTML para revisar la ficha en el navegador. Se guardan además las fuentes, las comprobaciones locales, el uso comunicado por la API y un informe de revisión separado.
Ese informe queda vinculado a los archivos mediante sus huellas digitales, que permiten detectar modificaciones posteriores. El resultado mantiene su condición de borrador privado y deja visibles las cuestiones que requieren atención antes de utilizarlo en un catálogo.
Durante la preparación del programa se han realizado pruebas con respuestas simuladas y se ha utilizado un expediente guardado para comprobar la salida y su presentación. La investigación completa con una cuenta real de DeepSeek queda como comprobación previa al uso en producción, junto con la medición de tiempos y consumo.
Sobre esta base hemos preparado la planificación del servicio API . La operación principal permitirá enviar un EAN y recuperar una ficha almacenada. Cuando haga falta generarla, la aplicación registrará un trabajo y devolverá un identificador para consultar su evolución.
La respuesta distinguirá entre tener una ficha disponible y estar procesando una generación. Así, una aplicación podrá seguir utilizando la versión existente mientras se prepara una actualización. Las solicitudes simultáneas del mismo producto compartirán el trabajo activo , y una actualización fallida conservará la ficha anterior .
La arquitectura propuesta utiliza FastAPI para atender las peticiones, PostgreSQL para guardar productos y trabajos, y un proceso Python independiente para ejecutar la generación. El despliegue está planteado con Docker Compose para mantener una base común entre localhost y un servidor Debian.
La planificación incluye autenticación, historial de versiones, cancelación, límites de consumo, recuperación tras reinicios y copias de seguridad. También define las pruebas necesarias para comprobar que los trabajos aceptados quedan registrados y que los resultados se recuperan correctamente.
El siguiente hito será implementar esa API y verificar el recorrido completo: solicitar una ficha, consultar su estado, revisar el resultado y reutilizarlo en peticiones posteriores.