Cuando gestionas miles de referencias, consultar una página de producto no consiste solo en obtener un precio. Necesitas saber qué página se recibió, si corresponde al producto solicitado, qué información contiene y si el resultado llegó a tu catálogo . En LiveCommerce estamos mejorando el servicio que consulta fichas de Amazon para que esas respuestas sean más útiles, verificables y fáciles de reutilizar.
El trabajo combina mejoras ya comprobadas con otras todavía en desarrollo. Aquí explicamos qué puedes aprovechar hoy, qué hemos medido en pruebas concretas y qué seguimos afinando antes de hablar de una mejora general de capacidad.
Del ASIN a una ficha que puedes comprobar
El servicio recibe referencias de producto, organiza las consultas y conserva los resultados de las páginas capturadas. Para una tienda con un catálogo amplio, esto permite alimentar tareas de actualización sin tener que abrir manualmente cada ficha. La respuesta no debería limitarse a un «funcionó» o «falló»: también debe distinguir una ficha válida, una página no encontrada y un problema temporal de navegación.
Las rutas de consulta de precio y disponibilidad siguen siendo importantes para revisar productos ya incorporados. Las rutas de alta necesitan, además, contenido suficiente para preparar o revisar la ficha. Por eso hemos incorporado una vía específica que obtiene el HTML bruto de la página en las altas de Amazon Alemania. El contenido se guarda en la misma infraestructura de artefactos y puede recuperarse después para analizar qué devolvió la fuente en ese momento.
Esta vía de HTML utiliza un proveedor externo. No sustituye por completo al navegador de captura que ya se emplea en otros flujos: son operaciones distintas y sus resultados no deben confundirse. Tampoco convierte una página incompleta en una ficha válida ni garantiza que Amazon muestre siempre un precio o stock.
Una captura para ver lo que había en la página
El HTML facilita la extracción y el diagnóstico técnico; la captura de pantalla aporta una comprobación visual. Puede ayudar a revisar si una página mostraba un precio, un mensaje de disponibilidad o un panel que no se interpretó como esperábamos.
Hemos probado un proceso separado que toma el HTML ya guardado y lo representa con Playwright, cargando estilos e imágenes para generar una captura. Antes de publicarla, comprueba que sigue siendo una ficha del producto solicitado, que la ubicación mostrada corresponde a la solicitada y que los recursos visuales esenciales han cargado. La imagen se almacena junto al HTML y puede consultarse mediante el servicio de capturas. Es una representación del HTML obtenido, no una segunda consulta en directo al producto.
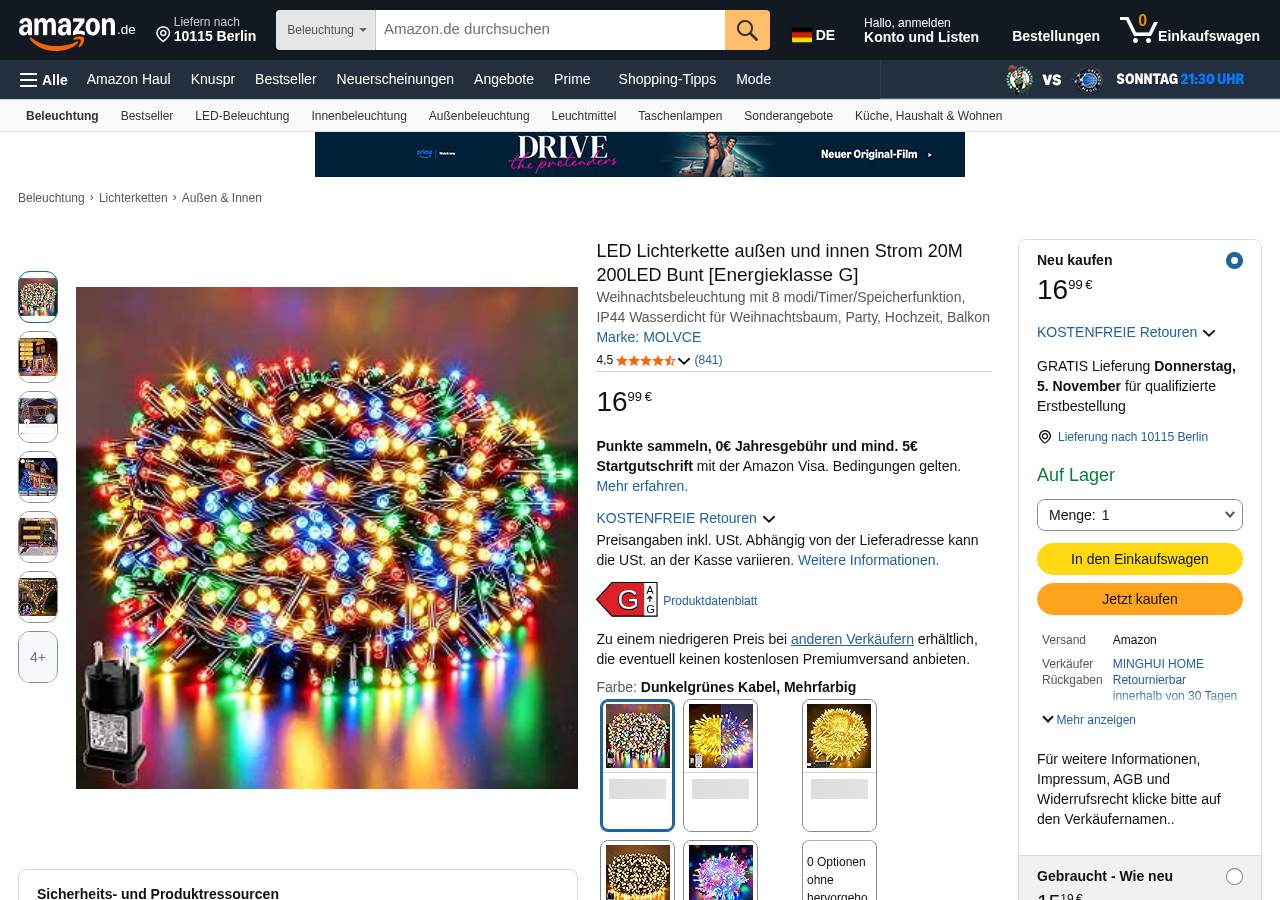
En una prueba controlada, el proceso completo de renderizar un HTML ya disponible, guardar el JPEG y sincronizarlo tardó 3,1 segundos para un producto. Varias tareas consecutivas registraron alrededor de cuatro segundos cada una. Estas cifras no incluyen la descarga inicial del HTML, el tiempo de espera en cola ni la extracción posterior de datos por el cliente. Tampoco permiten afirmar un tiempo medio garantizado para todas las fichas.
Reutilizar resultados sin repetir trabajo innecesario
Guardar el HTML y la imagen permite reutilizar una captura reciente y evita volver a solicitar la misma página en cada consulta. En la configuración comprobada para este flujo, la ventana de reutilización del artefacto es de 48 horas . Es una decisión operativa: reduce consultas repetidas, pero también implica que una respuesta de caché refleja una observación anterior y no necesariamente el estado de Amazon en este instante.
Para tu negocio, esa distinción importa. Si una referencia exige comprobar un cambio inmediato de precio, el proceso debe reconocer la antigüedad de los datos. Si lo que necesitas es preparar una ficha o investigar una incidencia reciente, el HTML y su captura guardados pueden aportar el contexto que faltaba. La reutilización ahorra trabajo; no sustituye una política de actualización adaptada a cada catálogo.
Más datos, pero sin confundir ausencia con error
Además de precio y stock, en las rutas de captura con navegador trabajamos con información adicional que puede aparecer en una ficha, como datos de seguridad, fabricante o persona responsable e información energética o EPREL cuando esté disponible. La presencia de esos bloques depende de lo que Amazon entregue para cada producto y de que la extracción se complete correctamente. La nueva vía de HTML bruto no garantiza por sí sola que esos datos estén enriquecidos.
Cuando un dato no aparece, lo responsable es conservar la diferencia entre «no se mostró», «no se pudo extraer» y «el producto no existe». La misma prudencia se aplica a precio y disponibilidad: no ver un precio no equivale a confirmar que el artículo esté agotado. En otro artículo explicamos por qué las respuestas incompletas no deben actualizar automáticamente tu catálogo .
Qué estamos afinando ahora
El objetivo no es solo captar más páginas, sino entregar más resultados útiles al cliente . Seguimos revisando los tiempos de cola, la distribución del trabajo, las respuestas parciales y la diferencia entre lo que solicita un cliente y lo que finalmente queda registrado en su catálogo. También estamos mejorando la observabilidad de cada trabajo para saber cuántas referencias se completaron, cuáles no se encontraron y cuáles fallaron, con su motivo.
La captura visual asíncrona ya se ha comprobado con artefactos reales y está procesando imágenes pendientes de forma limitada. Queda por completar y validar el encolado inmediato desde la ruta de alta; mientras tanto, la recuperación periódica puede introducir espera antes de que una imagen nueva esté disponible. No disponemos todavía de una medición comparable que demuestre un aumento global de ASIN entregados por día, por lo que no presentamos una cifra de capacidad como si ya estuviera conseguida.
Aplicaciones para un catálogo en crecimiento
Estas piezas sirven para preparar altas de productos, actualizar fichas existentes, revisar incidencias de precio o stock y conservar evidencia de la página utilizada en una decisión. En proyectos con muchas referencias, también ayudan a separar la revisión humana de las tareas repetitivas. Si quieres conocer el producto con el que organizamos parte de estas operaciones, puedes ver ShopinBot .
Como posibles desarrollos futuros, el HTML y las capturas podrían alimentar alertas visuales de cambios, comparaciones entre versiones de una ficha o controles adicionales de calidad antes de publicar un producto. Son aplicaciones posibles, no funciones nuevas que anunciemos como disponibles en este trabajo.
Seguiremos midiendo cada etapa por separado: descarga de HTML, generación de imagen, extracción de datos y entrega al cliente. Para una tienda, la mejora real es poder confiar en qué dato recibió, cuándo se obtuvo y qué hacer si la consulta quedó incompleta. Si tu catálogo tiene ese problema, cuéntanos cómo lo gestionas y estudiaremos qué comprobaciones y automatizaciones tienen sentido para tu caso.