Actualizar un catálogo con miles de referencias exige algo más que consultar muchas páginas: cada resultado debe llegar al producto correcto, con una ubicación válida y a tiempo para que la tienda pueda utilizarlo. Por eso estamos mejorando el recorrido completo de nuestro servicio de consulta de productos Amazon, desde la petición del cliente hasta la entrega del dato y sus artefactos.
El trabajo reciente se ha centrado en tres problemas prácticos: esperas innecesarias, capturas repetidas y respuestas que todavía no estaban listas para descargarse . Algunas correcciones ya funcionan en producción; otras siguen bajo medición. Explicamos qué hemos cambiado y qué significa para quien gestiona un catálogo amplio.
El proxy se elige cuando un nodo empieza a trabajar
Antes, una petición podía quedar en cola con un proxy ya reservado. Si ese proxy dejaba de estar disponible o se acumulaban trabajos, la reserva temprana dificultaba aprovechar los recursos libres. Ahora, para los trabajos de captura con navegador, el nodo selecciona y reserva un proxy del país solicitado al reclamar el trabajo . La petición puede esperar en cola sin bloquear prematuramente una salida de red.
El cambio no consiste en aceptar cualquier página para ganar velocidad. Se siguen comprobando señales como el país, el código postal y la moneda antes de tratar el resultado como válido. Si una página muestra una ubicación incorrecta o el proxy falla, esa información debe quedar identificada; no debe convertirse en un precio aparentemente correcto para tu tienda.
Resultados recientes que se pueden reutilizar
La reutilización de capturas evita consultar repetidamente la misma ficha cuando ya existe un resultado reciente. Detectamos que una parte de los artefactos terminados y sincronizados no entraba a tiempo en el índice que utiliza la caché. Corregimos ese recorrido para indexar los trabajos por su finalización, no solo por su creación.
En una cohorte cerrada de comprobación, 28.809 de 28.809 capturas sincronizadas quedaron registradas en el índice. Esa cifra verifica la reconciliación de esa cohorte concreta: no significa que todas las fichas futuras estén siempre disponibles ni que una respuesta de caché sea una consulta en directo. Para decisiones sensibles al tiempo, como precio y stock, seguimos distinguiendo cuándo se obtuvo el dato.
Menos insistencia cuando la API o el archivo aún no están listos
También hemos ajustado el diálogo entre la API y el cliente. Cuando la capacidad de admisión está ocupada, la respuesta indica cuánto conviene esperar; el cliente aplica esperas crecientes y una pequeña variación para que muchos procesos no vuelvan a llamar al mismo segundo. Si un HTML anunciado como listo aún no se puede descargar, evita repetir varias descargas inmediatas y continúa siguiendo el mismo trabajo.
Así se reduce trabajo redundante sin perder la relación con la petición original. El objetivo real no es recibir más respuestas de la API, sino registrar más resultados útiles en el catálogo. La reducción exacta de peticiones repetidas y su efecto sobre los registros de cada cliente siguen en revisión; no presentamos ese beneficio como una cifra ya demostrada.
HTML, captura visual y datos de producto
La consulta de precio y disponibilidad forma parte del flujo habitual. Para las altas de productos en Amazon Alemania hemos añadido además una vía específica de recuperación de HTML, que se conserva como artefacto. Una captura visual permite revisar qué mostraba la ficha en un momento concreto: imagen, ubicación, precio visible o mensajes de stock. Son operaciones distintas; descargar HTML no equivale a renderizarlo, y ninguna de las dos garantiza por sí sola que un precio esté disponible.
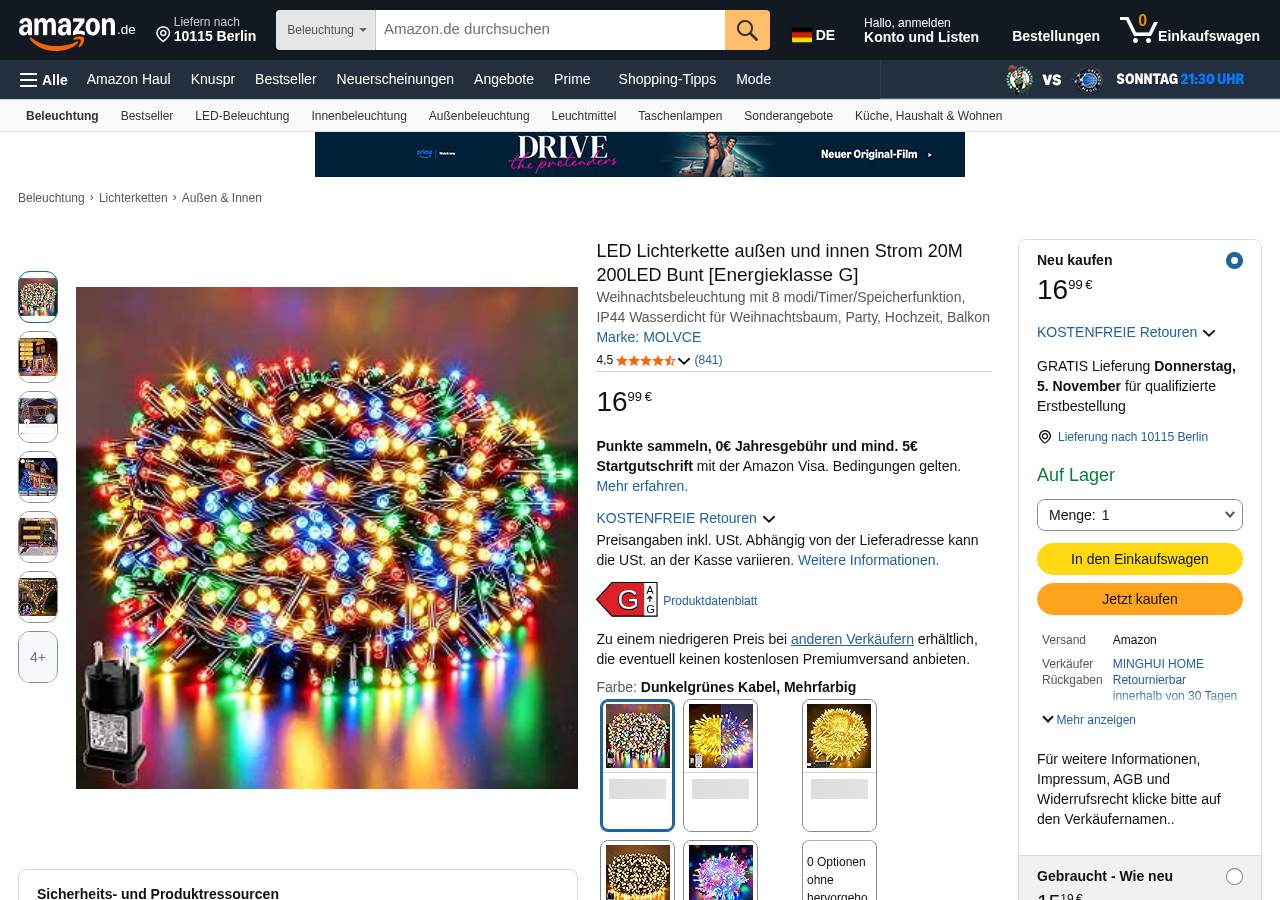
En la noticia sobre HTML y capturas verificables explicamos estas capacidades con más detalle, incluida la diferencia entre una página guardada y una nueva consulta en directo.
Qué dicen las mediciones y qué no dicen
Tras las correcciones del 30 de octubre, comparamos dos ventanas consecutivas de 30 minutos de trabajos finalizados. Los errores queue_timeout pasaron de 480 a 0 y los navigation_transient_error de 2.084 a 71 ; los resultados correctos pasaron de 5.609 a 5.916 . Son datos observados en esas ventanas, no una velocidad garantizada. Se aplicaron varias correcciones cercanas en el tiempo y cambió la mezcla de demanda y caché, por lo que no atribuimos toda la variación a una única modificación.
Seguimos midiendo por separado las peticiones, los productos únicos completados, las capturas nuevas y las respuestas reutilizadas. También ampliamos de forma controlada la concurrencia de un nodo tras verificar su funcionamiento, pero sus primeras pruebas no bastan para prometer una mejora sostenida de capacidad. La ubicación, el precio y el stock válidos siguen teniendo prioridad sobre cualquier cifra de velocidad.
Lo que todavía estamos resolviendo
Hay dos comprobaciones especialmente importantes antes de dar por cerrado el trabajo: confirmar que un producto marcado como listo ya tiene su HTML accesible, y relacionar cada resultado de la API con el registro que finalmente guarda el cliente. También estamos investigando rechazos de identidad de ASIN en la vía de HTML para distinguir una página incorrecta de una variante válida, sin relajar la validación a ciegas.
Para una tienda, el beneficio buscado es claro: menos consultas desperdiciadas, resultados trazables y una actualización del catálogo más fiable . Si necesitas revisar grandes lotes de productos, automatizar precios y stock o conservar evidencia de lo que mostraba una ficha, cuéntanos tu caso y estudiaremos qué flujo y frecuencia de actualización encajan con tu catálogo.